Le carnet

Articles IA, ce qu'on apprend en s'en servant vraiment

Des observations tirées d'un usage quotidien, en cabinet de conseil, sur de vrais dossiers d'entreprise. Ce qui marche, ce qui ne marche pas encore, et ce que les annonces de sortie ne disent jamais.

Ce qui change tout, c'est le contexte, pas le modèle

La qualité brute des réponses a cessé d'être le facteur limitant il y a un moment. Ce qui sépare aujourd'hui quelqu'un qui trouve ces outils décevants de quelqu'un qui leur confie une partie de son travail, ce n'est ni le modèle choisi, ni un talent particulier pour formuler des demandes.

C'est ce qu'il y a autour : ce que l'outil sait de vous, ce à quoi il a accès, et ce qu'il est capable de faire tout seul. Décrire coûte plus cher que faire, et c'est pour cette raison qu'un outil comme Claude Code change une journée de travail alors qu'une simple fenêtre de conversation la complique parfois.

Le raisonnement complet est sur la page consacrée au context engineering.

Une consigne écrite une fois vaut mieux que répétée vingt fois

La plupart des gens recommencent chaque conversation à zéro : rappeler le contexte, le ton, les interdits, le format attendu. Écrire ces règles une seule fois dans un fichier que l'outil relit à chaque session supprime ce travail entièrement.

C'est le geste qui sépare quelqu'un qui trouve l'IA « pas mal » de quelqu'un qui lui confie des tâches réelles. Et il ne demande aucune compétence technique : c'est de la mise par écrit, rien d'autre.

Une mémoire qui grossit finit par oublier

Le réflexe qui suit la mise par écrit, c'est d'agrandir le fichier de règles à chaque chose apprise. Ça tient quelques semaines, puis le fichier dépasse ce que l'outil charge, et chaque nouvelle règle en pousse une ancienne hors du champ de vision. Sans aucun avertissement.

La sortie n'est pas de faire plus court, elle est de changer la nature du fichier : il ne contient plus ce qu'on sait, il contient ce qu'on ne peut pas se permettre de chercher, plus la manière d'aller chercher le reste. Le détail, avec les pannes mesurées et le protocole complet, est sur la page consacrée à la mémoire de Claude Code.

Le vrai obstacle n'est jamais technique

Sur les mandats où l'adoption échoue, la cause n'est presque jamais l'outil. C'est qu'on n'a pas su découper le travail en demandes assez précises pour qu'un résultat soit vérifiable.

Une demande large produit un résultat inexploitable, une demande bornée produit quelque chose qu'on peut relire et garder. Découper un travail en morceaux vérifiables est une compétence de métier, pas d'informatique : c'est ce qui s'acquiert en formation, et ça ne dépend d'aucun outil.
observations

Cinq choses vérifiées à l'usage

Elles se répètent d'un mandat à l'autre, quel que soit le secteur, et aucune n'a de rapport avec la puissance du modèle.

La première réponse est rarement la bonne

Personne ne rend un document au premier jet, et il n'y a aucune raison d'attendre l'inverse d'un outil. Ce qui distingue les gens efficaces n'est pas la qualité de leur première demande : c'est le nombre de corrections qu'ils enchaînent ensuite, chacune tenant en trois mots.

La fluidité trompe

Un texte faux est écrit exactement aussi bien qu'un texte juste. C'est ce qui rend la relecture difficile : on est séduit par la phrase avant d'avoir vérifié le fait. La parade est de lire l'enchaînement du raisonnement en ignorant volontairement le style.

Les chiffres sont le point faible

Un montant, une date, un article de loi, une référence : ce sont les seuls endroits où une erreur est à la fois probable et grave. Ils se vérifient à la source, jamais en redemandant à l'outil, qui confirmera volontiers sa propre erreur.

Le gain se voit sur le volume, pas sur l'exploit

Ce qui impressionne en démonstration, c'est une tâche spectaculaire. Ce qui change une semaine de travail, c'est la même tâche ennuyeuse faite quarante fois. Les entreprises qui gagnent du temps sont celles qui ont trouvé leur tâche répétitive, pas celles qui ont trouvé le meilleur outil.

Ce que les annonces ne disent pas

Chaque sortie de modèle s'accompagne de comparaisons chiffrées sur des tests standardisés. Ces chiffres sont réels, et ils ne prédisent presque rien de ce que vous obtiendrez.

Parce que votre résultat ne dépend pas seulement du modèle : il dépend de ce que vous lui donnez, et de ce à quoi il peut accéder. Un modèle moyen avec un bon contexte bat systématiquement un excellent modèle sans contexte, et cet écart est bien plus grand que celui entre deux générations de modèles.

C'est pour cette raison que ce site ne publie aucun classement de performances : il serait faux avant d'être lu.

Les guides de fond

  • →
    Claude expliqué en français
    Ce qu'il sait faire et ne sait pas faire, gratuit contre payant, comparaison avec ChatGPT, et la question des données depuis la Suisse.
  • →
    Claude Code
    L'outil qui travaille directement dans vos fichiers, ce qui le sépare d'une conversation, et les trois précautions à connaître.
  • →
    La méthode du contexte
    La formule, les trois piliers, le fichier de règles, et les huit principes nés d'erreurs réelles.

Les articles courts paraissent au fil de l'eau et sont classés ici dès leur publication.

Trois idées reçues qui coûtent cher

Elles reviennent dans presque chaque première séance, et elles empêchent d'obtenir quoi que ce soit d'utile tant qu'elles ne sont pas levées.

« Il faut savoir écrire des prompts »

C'est l'idée la plus répandue, et la moins vraie. La formulation compte, mais elle compte infiniment moins que ce qu'on fournit. Une demande médiocre accompagnée du bon document produit un meilleur résultat qu'une demande parfaitement tournée sans rien autour.

Le marché des formations a beaucoup insisté sur la formulation parce que c'est ce qui se vend le plus facilement : c'est visible, ça se démontre en trois minutes, et ça donne l'impression d'un savoir-faire. Le travail réel est ailleurs, il est moins spectaculaire, et il tient dans ce qu'on prépare avant de demander.

« Ça va halluciner, donc c'est inutilisable »

L'objection est fondée sur un fait réel, mais elle en tire une conclusion fausse. Oui, un modèle peut avancer une information inexacte avec assurance. Non, cela ne rend pas l'outil inutilisable : cela rend obligatoire une étape de vérification, ce qui est exactement ce qu'on fait déjà avec le travail d'un collaborateur junior.

La bonne question n'est pas « est-ce que ça se trompe » mais « est-ce que je peux vérifier vite ». Sur un texte dont on fournit les sources, la vérification prend deux minutes. Sur une question de culture générale posée à froid, elle est impossible. C'est ce qui décide de l'usage, pas la fiabilité brute du modèle.

« Il faut attendre la prochaine version »

Attendre est la stratégie la plus coûteuse, parce qu'elle repousse indéfiniment le seul travail qui compte : construire son contexte. Ce travail ne se périme pas quand le modèle change. Celui qui l'a commencé il y a six mois a six mois d'avance, quel que soit le modèle qu'il utilise aujourd'hui.

Le raisonnement complet est développé sur la page context engineering : le modèle est le facteur sur lequel vous n'avez aucune prise, et c'est précisément celui sur lequel tout le monde concentre son attention.

méthode

Comment je vérifie ce que je publie

Ce site affirme des choses sur des produits qui changent toutes les semaines. Voici la procédure appliquée, parce qu'une page qui parle de vérification devrait dire comment elle vérifie.

Extraire, pas relire

Toutes les affirmations portant sur le monde extérieur sont extraites mécaniquement, page par page. Une relecture au jugé laisse toujours passer l'affirmation qui paraît évidente, et c'est précisément celle-là qui est fausse.

Source primaire uniquement

Documentation de l'éditeur, texte de loi, page officielle. Jamais un article de blog seul, jamais une reprise de reprise. Quand la source primaire n'existe pas, l'affirmation ne figure pas sur le site.

Dater ou renvoyer

Ce qui change vite n'est pas recopié : on renvoie à la source. Ce qui est publié porte sa date de vérification. Le comparatif de la page Claude IA en est l'exemple : il ne compare plus aucune performance, volontairement.

Cette procédure a déjà servi. En vérifiant le comparatif entre Claude et ChatGPT, une affirmation de ce site s'est révélée fausse : elle donnait un avantage à l'un des deux sur les documents longs, alors que les deux familles disposent d'une fenêtre de contexte comparable. Elle a été retirée, et tous les classements de performances avec elle.

Ce qui a changé en dix-huit mois, et ce qui n'a pas bougé

Le rythme des annonces donne l'impression que tout se renouvelle chaque trimestre. En regardant ce qui a réellement modifié la façon de travailler, la liste est courte.

Ce qui a vraiment changé

L'accès aux fichiers, d'abord. Passer d'un outil auquel on décrit ses documents à un outil qui les ouvre est le seul changement de nature de la période. Tout le reste est une question de degré.

La capacité à enchaîner plusieurs étapes seul, ensuite. Un outil qui lit, écrit, vérifie et recommence sans qu'on l'accompagne à chaque étape ne fait pas la même chose qu'un outil qui répond à une question. C'est ce qui sépare une conversation d'un agent.

Et la longueur des documents traitables, enfin, qui a cessé d'être une contrainte pratique pour la plupart des usages de bureau.

Ce qui n'a pas bougé d'un pouce

La nécessité de vérifier. Aucun progrès n'a supprimé le besoin de contrôler les chiffres, les dates et les références à la source. Les modèles se trompent moins souvent, ce qui rend la vérification plus difficile, pas moins nécessaire : une erreur rare au milieu de vingt réponses justes se repère moins bien qu'une erreur sur deux.

La nécessité de fournir du contexte, ensuite. Un modèle plus puissant sans contexte reste un modèle qui ne sait rien de vous. L'écart entre avec et sans contexte est resté bien plus grand que l'écart entre deux générations de modèles.

Et la nécessité de savoir découper une tâche, qui reste la compétence déterminante, et qui n'a rien de technique.

Ce qui progresse est ce sur quoi vous n'avez aucune prise. Ce qui ne progresse pas est exactement ce sur quoi vous pouvez travailler.

Lire ne suffit pas, il faut essayer sur ses propres dossiers

C'est là que ces observations prennent un sens : sur vos documents, vos contraintes et vos habitudes de travail, pas sur des exemples de démonstration.

~/documents/methode-memoire-ia.pdf
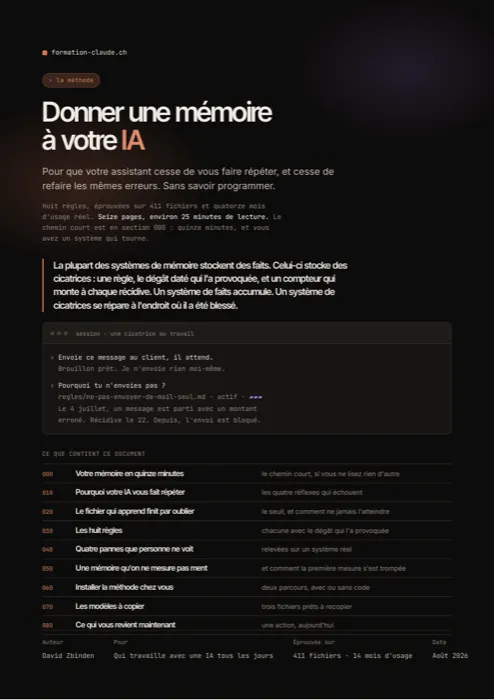
Première page du document, Donner une mémoire à votre IA
17 pages, environ 25 minutes de lecture
le document, gratuit

Donner une mémoire à votre IA

Pour que votre assistant cesse de vous faire répéter, et cesse de refaire les mêmes erreurs. Sans savoir programmer.

  • →
    Les huit règles, chacune avec le dégât qui l'a provoquée.
  • →
    Les trois modèles de fichiers, prêts à recopier.
  • →
    La grille de mesure, pour savoir si votre mémoire tient.

Une adresse, rien d'autre. Le document arrive dans l'instant, puis cinq courriels sur onze jours pour vous aider à l'appliquer. Désinscription en un clic, adresse jamais transmise.

● en ligne · ~/articles-ia/ · fr-CH · UTF-8 maj 2026-09-25